在线搜题并非简单的"拍照—出答案"工具,它本质上是教育内容结构化与信息检索技术融合的产物。据中国互联网络信息中心(CNNIC)第53次《中国互联网络发展状况统计报告》,截至2024年6月,我国在线教育用户规模达3.4亿,其中利用移动端进行课后学习辅助的用户占比超过六成。在这一背景下,在线搜题类平台已从边缘化的"答案工具"逐步演化为连接题库数据、自然语言处理与个性化学习路径的教育信息服务节点。本文尝试从技术架构、数据治理与行业生态三个维度,解析在线搜题的真实运行逻辑。
一、技术底座:OCR与语义检索构成的双引擎
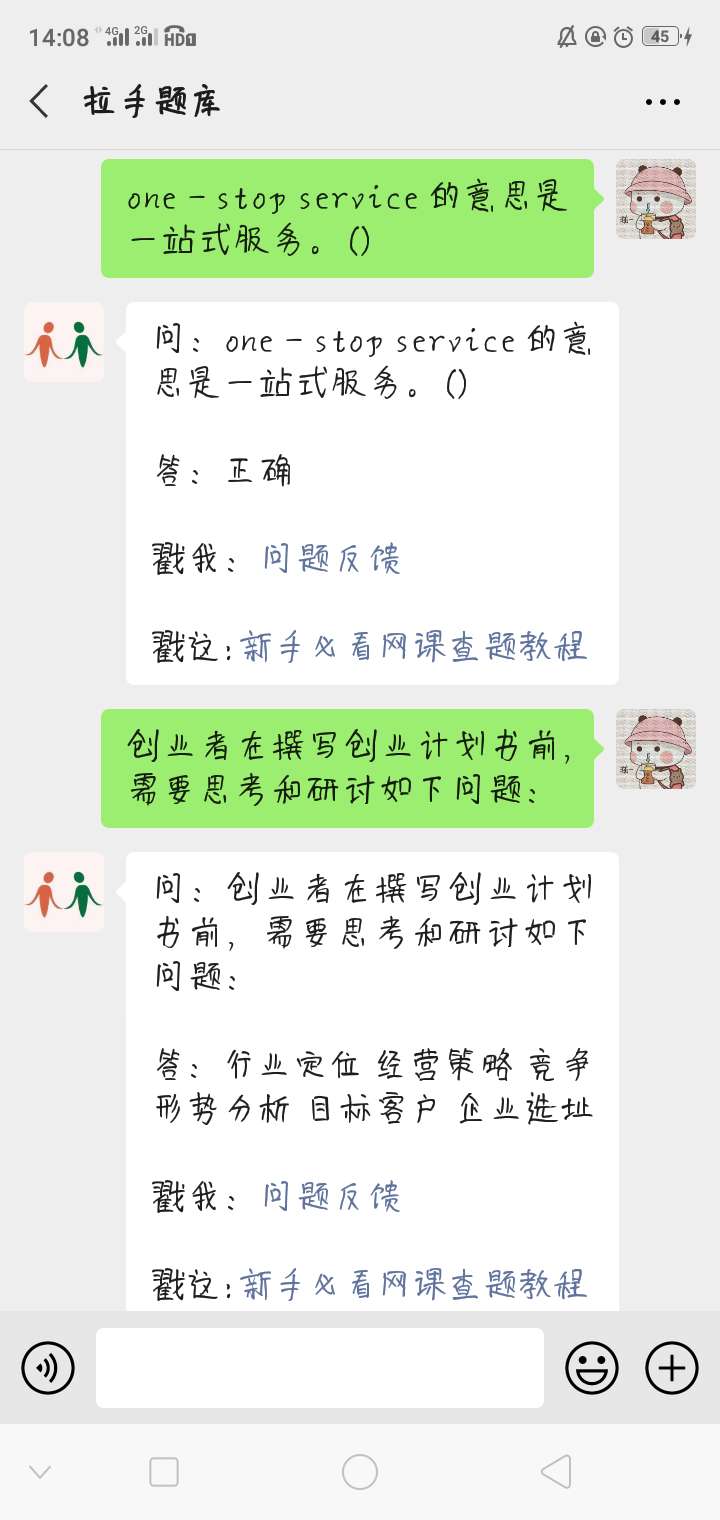
在线搜题的核心技术链路可拆解为"输入识别—语义匹配—答案渲染"三段式结构。输入端依赖OCR光学字符识别技术,将图片中的题干文字转化为可检索文本;中段则依托倒排索引与向量检索相结合的混合架构,在海量题库中完成相似度匹配;输出端通过结构化模板渲染解析步骤与知识点标注。
以行业内公开的技术实践为例,主流查题网站在处理一道高等数学极限题时,需在毫秒级完成公式符号的LaTeX化解析,再与题库中带标签的解析条目做语义对齐。这一过程对题库的标注质量提出极高要求——若题目解析缺乏知识点粒度标注,检索精度将显著下降。因此,考试题库的建设并非简单的文本堆砌,而是涉及题目分类学、知识点图谱与难度分级的系统工程。
二、数据治理:题库质量决定搜题答案的可信度
行业调研数据显示,一个中等规模的大学课后习题答案库通常覆盖30至50个学科门类、逾百万道题目,其中约15%的条目需要定期复核更新。教材版本迭代、考纲调整以及学科交叉内容的增加,使得题库维护成为一项持续性工程。
- 版本对齐机制:针对不同出版社的教材版本,题库需建立"教材—章节—题号"三级映射关系,避免出现答案与题干错配。
- 解析质量分级:按"仅答案—简要解析—完整步骤—知识点延伸"四级标准标注,帮助用户按需获取。
- 纠错反馈闭环:引入用户报错与专家复核双通道,将纠错响应周期控制在可接受范围内。
这些治理动作看似琐碎,却直接决定了搜题答案的可用性。网课答案查询场景尤其依赖此类治理——线上课程的题目往往随学期动态更新,题库若缺乏敏捷的采集与校验流程,便难以支撑稳定的查询服务。
三、行业生态:从单点工具到学习服务协同
从产业视角看,在线搜题处于信息技术服务业与教育内容产业的交汇地带。其上游是软件开发与系统集成能力,中游是题库数据资产,下游则连接着学生、教师与课程平台。近年来,部分平台开始将搜题能力以API形式嵌入高校教务系统或学习管理平台,形成"题目解析服务"的模块化输出,这与信息传输、软件和信息技术服务业中平台化、服务化的整体趋势一致。
值得关注的是,免费查题模式的可持续性依赖于边际成本控制。云计算资源的弹性调度与缓存策略的优化,使得单次查询的算力开销被压缩至较低水平,这也是免费服务能够长期运转的技术前提。与此同时,题目答案解析的版权合规、数据安全与隐私保护,正成为行业规范化发展的关键议题。
结语
在线搜题的价值不应被简化为"找答案"。当题库建设走向结构化、检索技术走向语义化、服务模式走向平台化,搜题神器这一形态正在成为教育数字化的基础组件之一。对从业者而言,真正的竞争壁垒不在流量入口,而在题库治理的精细度与检索架构的工程能力——这或许才是这一细分领域最值得深耕的方向。